ChatGPT repose sur un modèle de langage (LLM) dont le fonctionnement se résume, en surface, à une prédiction de token. Derrière cette mécanique apparemment simple se nichent des choix d’architecture, d’entraînement et d’inférence qui déterminent la qualité des réponses et leurs limites opérationnelles.
Jetons internes et fenêtre de contexte : le coût caché de l’inférence ChatGPT
Un point rarement abordé dans les présentations grand public concerne les jetons internes de raisonnement. Certains modèles d’OpenAI produisent des tokens qui ne s’affichent pas dans la réponse visible. Ces jetons servent au traitement intermédiaire de la requête, mais ils consomment une partie de la fenêtre de contexte et sont comptabilisés comme jetons de sortie.
A voir aussi : Quelles sont les limites de la blockchain ?
Concrètement, une réponse de quelques lignes peut avoir mobilisé bien plus de calcul que sa longueur ne le suggère. Pour un développeur qui appelle l’API, cela signifie une facturation supérieure au nombre de tokens affichés.
La fenêtre de contexte fixe la quantité totale de texte (entrée + sortie + jetons internes) qu’un modèle peut manipuler en une seule passe. Quand cette limite est atteinte, le modèle perd l’accès aux premières portions de la conversation. La gestion de cette fenêtre reste l’un des arbitrages techniques majeurs lors du déploiement d’un LLM en production.
A lire également : Comment fonctionne une batterie de stockage ?
Tokenisation et embeddings : comment ChatGPT découpe le texte
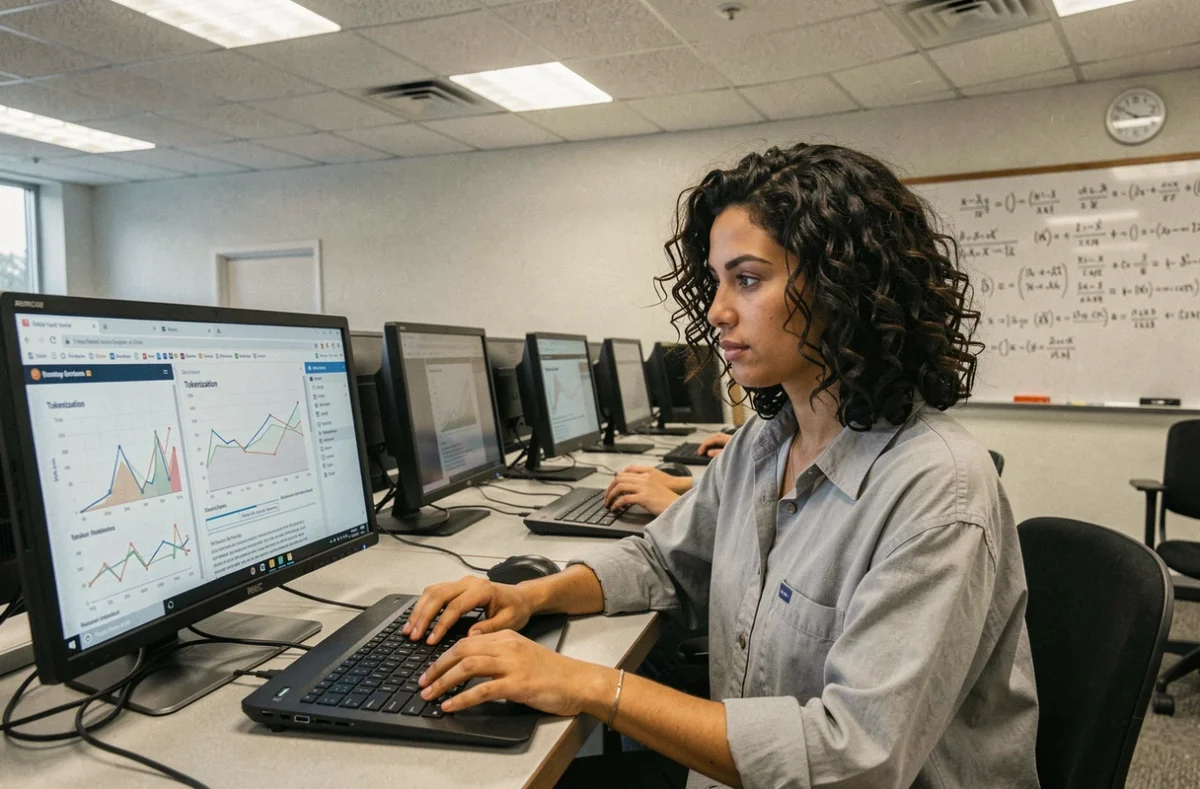
Avant toute opération, le modèle convertit le texte en tokens, des fragments qui ne correspondent pas toujours à un mot entier. Un terme long sera scindé en sous-unités. Le mot « fonctionnement » peut générer deux ou trois tokens distincts selon le vocabulaire du tokenizer.
Chaque token est ensuite projeté dans un espace vectoriel de grande dimension. Ces vecteurs, appelés embeddings, encodent les relations sémantiques entre les fragments. Deux tokens proches par le sens se retrouvent proches géométriquement dans cet espace.
L’étape de tokenisation conditionne directement la performance du modèle sur les langues autres que l’anglais. Un tokenizer optimisé pour l’anglais découpe le français en davantage de tokens, ce qui réduit la quantité d’information utile dans la fenêtre de contexte et augmente le coût d’inférence.
Architecture Transformer du modèle GPT : mécanisme d’attention
Le T de GPT désigne Transformer, l’architecture publiée en 2017. Son apport principal est le mécanisme d’attention (self-attention) qui permet au modèle de pondérer l’importance de chaque token par rapport à tous les autres dans la séquence, en parallèle plutôt que séquentiellement.
GPT utilise spécifiquement un Transformer décodeur. Il traite la séquence de gauche à droite : chaque token ne « voit » que les tokens précédents, jamais ceux qui suivent. Cette contrainte directionnelle est ce qui rend le modèle génératif.
Les paramètres du modèle sont les poids numériques de ces couches d’attention et des couches de transformation qui suivent. Plus le nombre de paramètres est élevé, plus le modèle dispose de capacité pour capturer des relations fines entre tokens. Les modèles GPT récents comptent plusieurs centaines de milliards de paramètres.
Entraînement et alignement d’un LLM : du pré-entraînement au RLHF
L’entraînement d’un modèle comme GPT se déroule en phases distinctes dont les objectifs diffèrent :
- Pré-entraînement (pre-training) : le modèle ingère un corpus massif de textes et apprend à prédire le token suivant. Cette phase fixe les connaissances linguistiques et factuelles du modèle, mais ne produit pas encore un assistant conversationnel.
- Fine-tuning supervisé : des annotateurs humains rédigent des exemples de dialogues conformes au comportement attendu. Le modèle ajuste ses poids pour reproduire ce style de réponse.
- RLHF (Reinforcement Learning from Human Feedback) : des évaluateurs classent plusieurs réponses du modèle par ordre de préférence. Un modèle de récompense est entraîné sur ces classements, puis utilisé pour affiner le LLM par apprentissage par renforcement.
Le RLHF est la phase qui transforme un modèle de langage brut en assistant utilisable. Sans cette étape, le modèle génère du texte statistiquement plausible mais souvent hors sujet, voire nuisible.
Génération de texte token par token : sampling et température
Lors de l’inférence, le modèle calcule une distribution de probabilités sur l’ensemble de son vocabulaire pour chaque position. Il ne choisit pas toujours le token le plus probable. Un paramètre appelé température contrôle le degré d’aléatoire :
- Température basse (proche de 0) : le modèle privilégie systématiquement les tokens les plus probables. Les réponses sont répétitives mais prévisibles.
- Température élevée : la distribution est aplatie, les tokens moins probables ont davantage de chances d’être sélectionnés. Les réponses gagnent en variété mais risquent de perdre en cohérence.
- Top-p (nucleus sampling) : seul le sous-ensemble de tokens dont la probabilité cumulée atteint un seuil donné est considéré. Ce mécanisme complète ou remplace le réglage de température.
Le modèle ne « comprend » pas le texte au sens humain. Il produit une suite de tokens statistiquement cohérente avec le contexte reçu. Cette distinction est déterminante pour anticiper les hallucinations, ces réponses factuellement fausses mais linguistiquement fluides.
Recherche web et limites des données d’entraînement ChatGPT
Un LLM pré-entraîné reste figé dans le temps : ses connaissances s’arrêtent à la date de coupure du corpus. ChatGPT contourne partiellement cette limite grâce à une fonctionnalité de recherche web qui interroge des sources en temps réel.
OpenAI précise que les résultats et les citations issus de cette recherche peuvent être incomplets, obsolètes ou incorrects. Nous recommandons d’ouvrir systématiquement les sources citées pour vérifier qu’elles étayent bien la réponse.
La génération vocale illustre une autre évolution du fonctionnement de ChatGPT. L’API vocale en temps réel décrite par OpenAI utilise un modèle qui reçoit et produit directement de l’audio, sans passer par une chaîne intermédiaire parole-texte puis texte-parole. Cette approche réduit la latence et préserve mieux les nuances de la voix.
Ces extensions ne modifient pas le principe fondamental du LLM. Le cœur du système reste un Transformer décodeur qui prédit le prochain token. Chaque couche ajoutée (recherche web, voix, vision) s’articule autour de cette boucle de génération, en enrichissant le contexte d’entrée ou en transformant la modalité de sortie.